Apprendre à utiliser Nooloom
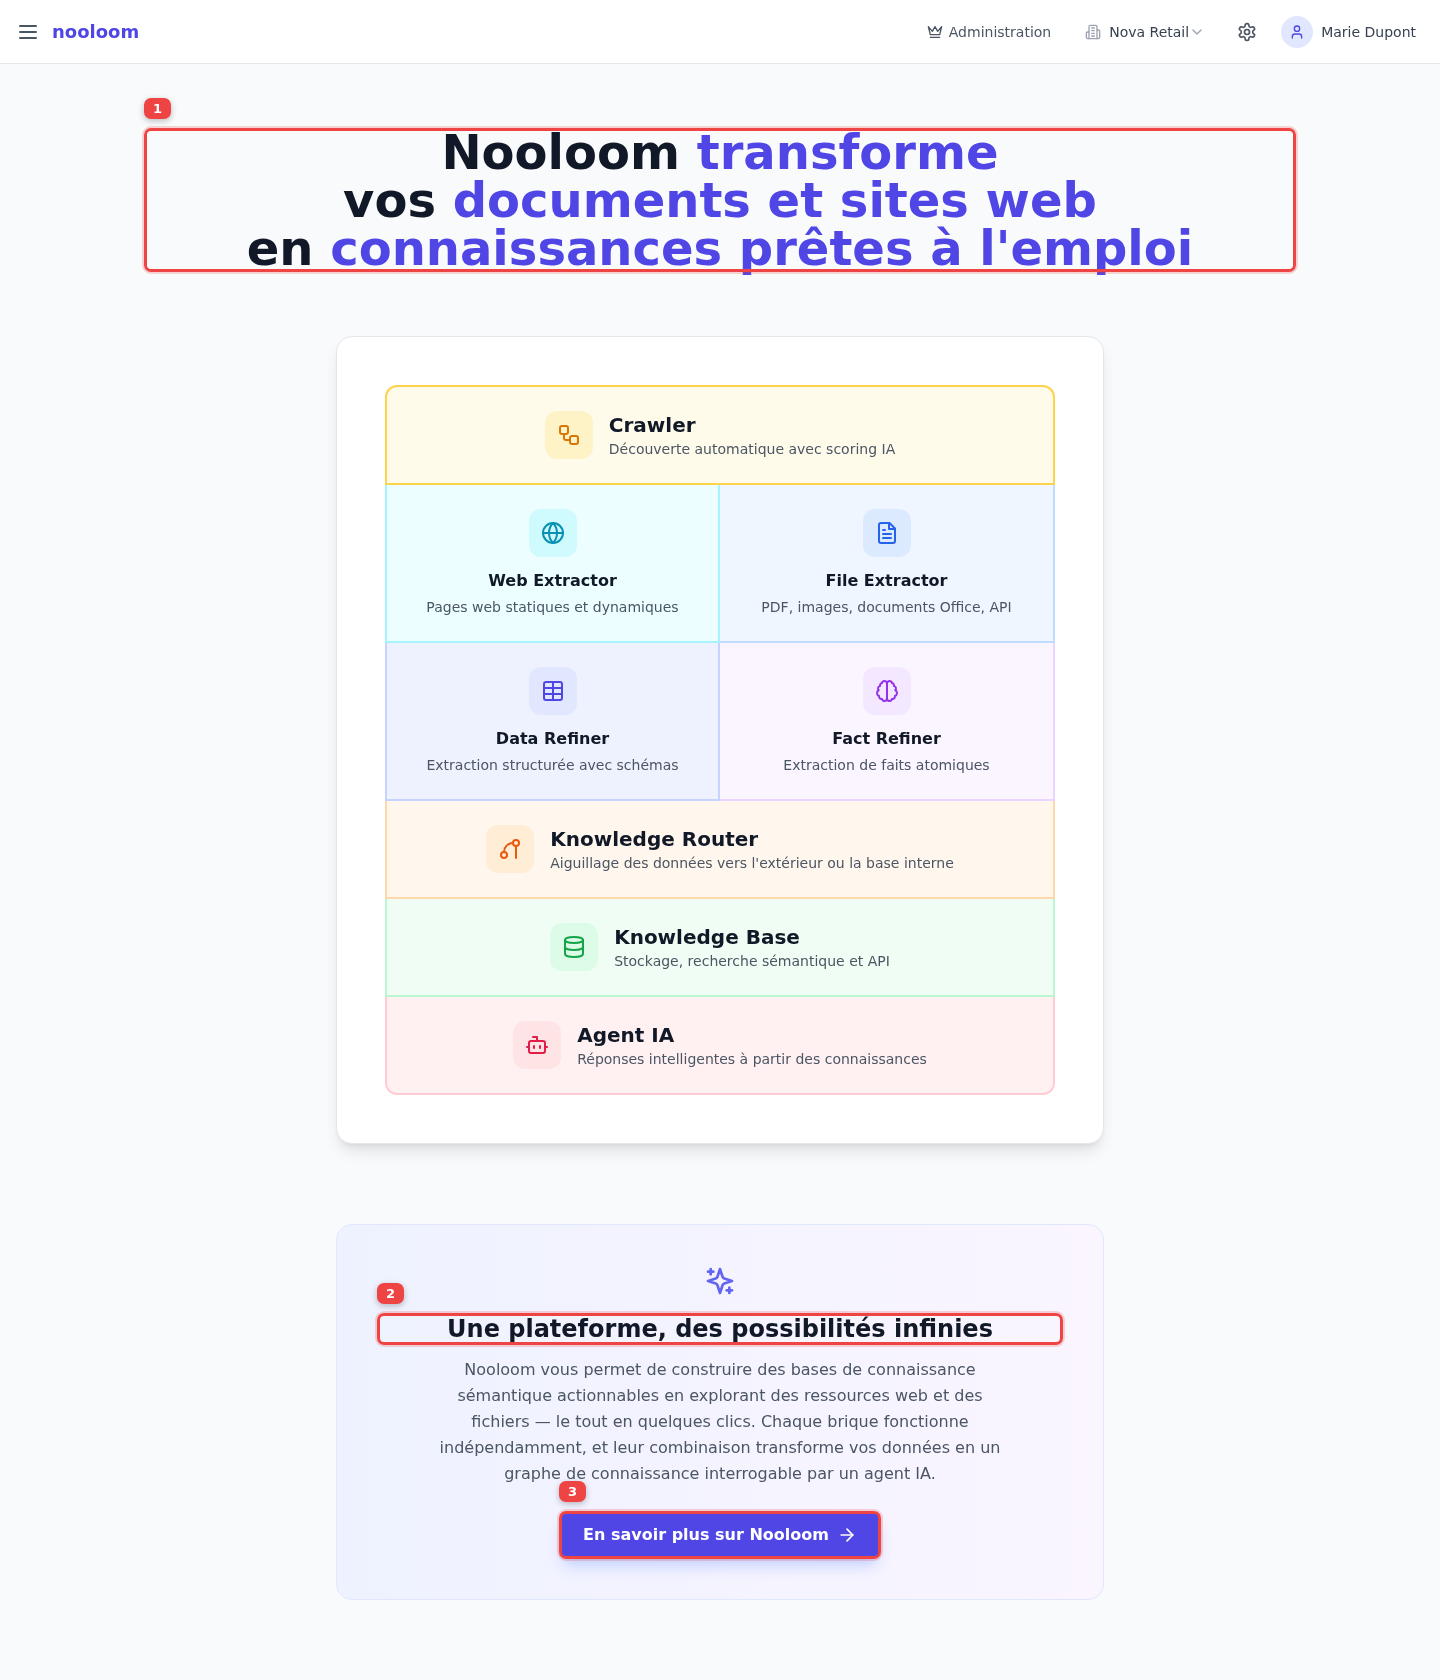
Nooloom transforme vos documents et sites web en connaissances prêtes à l'emploi. Ce guide vous prend par la main : ce que fait le logiciel, ses fonctionnalités (ce que vous utilisez dans le menu) et ses briques (les composants qui les rendent possibles).
Construire une base de connaissance sémantique actionnable à partir de ressources web et de fichiers, en moins de clics qu'il n'en faut pour lire cette phrase.
Pourquoi Nooloom ?
Vous avez des documents, des sites web et des fichiers dispersés. Nooloom les transforme en une base de connaissance interrogable : une recherche par le sens, pas seulement par mots-clés.
Base de données classique
- Recherche par mots-clés ou requêtes SQL.
- Structure figée définie à l'avance.
- Résultats exacts mais rigides.
- Ne comprend pas le contexte.
Base de connaissance sémantique
- Recherche par le sens (sémantique).
- Structure flexible et enrichie.
- Résultats pertinents même si les mots diffèrent.
- Comprend l'intention et le contexte.
Exemple : une question sur « la consommation d'énergie des serveurs » retrouvera un document parlant de « l'empreinte carbone des datacenters ».
Ce que vous utilisez dans le menu
Vous n'utilisez pas directement les briques : vous utilisez des fonctionnalités (Obtenir, Rechercher, Crawlers, Workflows…), chacune s'appuyant sur une ou plusieurs briques. Chaque fonctionnalité a sa page d'aide avec captures d'écran.
Workflow manuel
Une obtention (URL, fichier, texte) + une seule destination (raffinage puis cible : affichage, KB ou API externe).
Knowledge Bases
Rechercher par le sens dans vos connaissances, avec score et source.
Agents
Configurer puis discuter avec un agent RAG qui répond depuis vos bases, sources citées.
Crawlers
Explorer des sites automatiquement et alimenter les extracteurs.
Les 8 briques (les composants)
Une chaîne modulaire : découvrir → capturer → structurer → aiguiller → stocker → répondre. Chaque brique est documentée sommairement (ce qu'elle sait faire, sans captures) ; les usages détaillés sont dans les fonctionnalités.
Crawler
Découvre automatiquement des ressources web pertinentes : il parcourt les pages, suit les liens et score chaque ressource avec l’IA pour ne retenir que ce qui compte vraiment.
Capture de contenu webWeb Extractor
Obtient le contenu de pages web statiques et dynamiques (JavaScript, SPAs) : texte, tableaux et structures deviennent des données exploitables.
Obtention multi-formatFile Extractor
Importe des fichiers (PDF, images, documents Office) par upload, par API ou à la demande du crawler, et en structure automatiquement le contenu.
Obtention structurée sur mesureData Refiner
Définissez vos propres schémas (JSON Schema) et laissez l’IA obtenir précisément ce dont vous avez besoin dans des documents hétérogènes.
Obtention d'assertions atomiquesAssertion Refiner
Transforme vos documents en graphe de connaissances en extrayant des assertions — entités, relations, attributs — reliées entre elles.
Aiguillage des donnéesDestinations
Déclare où vont les données raffinées : une base d’assertions, une base de données (schéma JSON) ou une API externe (ERP, CRM). Un raffinage LLM est exécuté par destination.
Stockage et recherche sémantiqueKnowledge Base
Centralise toutes vos connaissances obtenues dans une base vectorielle. Recherche par le sens, pas par mots-clés. Accessible via API.
Assistant connecté à vos donnéesAgent IA
Discutez avec un agent RAG (Retrieval-Augmented Generation) qui puise dans vos bases de connaissance pour répondre avec précision, en citant ses sources.
Ouvrez la page dédiée aux briques ou découvrez le Frontoffice et le Backoffice.
Des cas d'usage concrets
Moteur de recherche interne
Indexez votre site et offrez une recherche sémantique qui répond précisément aux questions de vos visiteurs.
Traitement de commandes
Extrayez les données d’un PDF de commande et envoyez-les directement dans votre système d’information.
Support client
Construisez une base de connaissance SAV et faites traiter les nouveaux dossiers par un agent IA.
Veille concurrentielle
Surveillez les sites de vos concurrents et détectez automatiquement les nouveautés.
Catalogue fournisseurs
Extrayez les fiches produits selon un schéma unifié et acheminez les données vers votre ERP.
Audit documentaire
Importez contrats et CGV, extrayez clauses et obligations, vérifiez la conformité avec l’agent IA.
Parcours du guide
Les fonctionnalités
Ce que vous utilisez dans le menu : aide pas à pas avec captures.
Installation
Installez Nooloom en local : prérequis, secrets, démarrage et première connexion.
Le Frontoffice
L'espace de travail : obtenir, rechercher et discuter avec l'agent.
Le Backoffice
L'administration : crawlers, workflows, destinations, bases, agents, abonnement.
Qualité & résultats de tests
La plateforme est couverte par des tests unitaires, d'intégration et de bout en bout. Les rapports (résultats + couverture HTML) sont générés à chaque merge et publiés automatiquement sur ce site.
Le frontoffice sert à faire ; le backoffice sert à configurer. Chaque brique se pilote d'un côté ou de l'autre : le tableau en bas de chaque page vous dit où.